병목은 매번 나였다
다음 병목도 아마 나일 것이다.
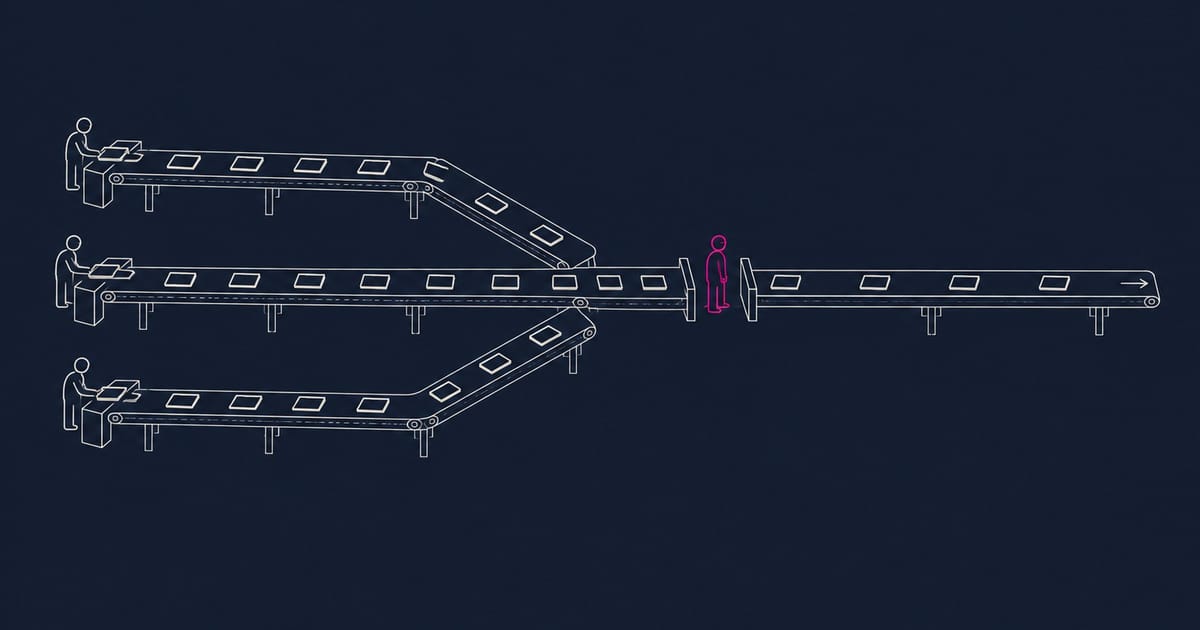
지금 내 터미널에는 코딩 에이전트 세션이 여러 개 떠 있다. 각각은 서로 다른 프로젝트를 맡고 있고, 필요할 때 서로에게 직접 말을 건다. 나는 각 세션이 정리해 온 결과와 근거를 읽고 결정한다. 어떤 세션이 무엇을 알아냈는지 옮겨 적거나, 어제의 결정을 다시 설명하는 일은 줄었다.
이런 환경을 갖추기까지 1년 반이 걸렸다. 도구를 여러 번 갈아탔고, 직접 만든 스킬을 몇 개 버렸다. 돌아보면 단계마다 병목이 하나씩 있었는데, 그 병목은 언제나 나 자신이었다. 더 정확히 말하면, 에이전트가 하지 못하는 일보다 내가 아직 넘겨주지 않은 일이 병목이었다.
컨텍스트 스위칭의 외주화에서는 실행을 맡긴 뒤에도 사람이 작업의 맥락을 다시 파악해야 하는 부담과, 언제 어떤 정보를 받아 판단할지 정하는 문제를 다룬다. 내 경우에는 사람이 개입할 때 필요한 정보를 정리하는 데서 한 걸음 더 나아갔다. 그 개입 자체가 필요한지, 검증과 수정의 반복까지 맡길 수는 없는지도 다시 생각했다.
이 글은 그 문제를 내 작업 환경에서 어떻게 풀어 왔는지에 대한 기록이다. 세션 사이의 전달과 기억에서 시작해 검증과 이해에 이르기까지, 내가 직접 하던 어떤 행동을 도구에 넘겼는지 따라가려 한다.
처음에는 왜 맡기지 못했을까?
2025년 3월쯤부터 Claude Code를 쓰기 시작했다. 그전에는 VS Code에서 GitHub Copilot을 함께 쓰다가 Cursor로 옮겨 간 정도였다. 자동완성에서 대화형 편집으로, 다시 터미널 에이전트로 넘어온 과정이었다.
도구가 바뀌어도 일하는 방식은 크게 달라지지 않았다. 설계도 구현도 내가 했고, 에이전트에게는 유닛 테스트 작성, CI 설정, 코드 리뷰, 오타 교정 정도를 맡겼다. 결과를 확인하기 쉽거나, 잘못되어도 부담이 작다고 여긴 일이었다. 세션도 하나만 띄워 놓고 대화하다가 일이 끝나면 종료했다.
당시에는 이것을 신중함이라고 생각했다. 지금 돌아보면 검증 비용에 대한 부담이 컸다. 에이전트가 만든 결과물을 읽고 판단하는 데 드는 비용이 직접 작업하는 비용보다 크게 느껴졌던 것이다. 코드가 이미 주어져 있어도 이해하고 검증하는 데에는 시간이 든다. 당시에는 그 과정을 전부 내가 해야 한다고 생각했다.
맡기는 일이 늘자 검증 외에도 내 손을 거치는 일이 많다는 것을 알게 됐다. 세션을 오가고, 알아낸 것을 전달하고, 이전 결정을 다시 설명하는 일이었다. 환경을 바꾸는 일은 이 행동들을 하나씩 찾아 넘기는 일이기도 했다.
한 세션이 일하는 동안 다른 일을 맡기기
2025년 말에 oh-my-opencode가 화제가 되는 것을 보고 OpenCode를 써 봤다. 당시 Claude Code는 UI 버그가 많았는데, OpenCode는 그에 비해 화면이 깔끔했다. 더 중요한 것은 한 창 안에서 여러 세션을 백그라운드로 실행할 수 있다는 점이었다. 이때 처음으로 세션을 여러 개 운용하는 방식에 익숙해졌다.
2026년에 들어서면서 앤트로픽이 구독 인증을 다른 도구에서 사용하는 것을 제한했고, OpenCode에서도 법적 요청에 따라 인증 플러그인을 제거했다.1 나는 다시 Claude Code로 돌아왔다. 마침 풀스크린 모드가 베타로 배포되면서 UI 문제도 상당 부분 해소된 시점이었다.
다만 OpenCode에서 익숙해진 백그라운드 세션이 없었으므로, tmux로 화면을 나누어 여러 세션을 띄웠다. 5월에 Claude Code가 Agents view를 리서치 프리뷰로 내놓으면서 다시 한 창 안에서 여러 세션을 쓰게 되었다.
중요한 변화는 한 세션이 작업하는 동안 다른 세션에 일을 맡길 수 있게 되었다는 점이다. 내가 결과를 읽고 판단하는 일은 여전히 하나씩 해야 했지만, 에이전트의 실행까지 내 작업 순서에 맞출 필요는 없어졌다.
세션 사이의 전달은 누가 하고 있었나?
세션을 여러 개 띄우고 나니 한 세션에서 알아낸 것을 다른 세션에 옮기는 일이 늘었다. 그 일을 내가 복사와 붙여넣기로 하고 있었다. 에이전트들은 병렬로 일하는데, 세션 사이의 통신은 모두 내 손을 거쳤다.
화면 없이 실행하는 헤드리스 모드로 다른 세션을 호출하는 방법도 있었다. 하지만 그 무렵 앤트로픽은 claude -p와 Agent SDK 사용에 별도 과금을 예고했다가 시행 당일에 철회했다.2 철회되었다고 해도, 매일 쓰는 기능을 과금 방식이 다시 바뀔 수 있는 정책에 의존하게 만들고 싶지는 않았다.
그래서 이미 사람이 보고 있는 세션에 입력을 넣는 방식을 택했다. tmux로 나눈 화면에 Claude Code를 띄워 두고, 다른 세션에 내용을 전달할 때는 키 입력 기능으로 해당 세션에 직접 써 넣는 스킬을 만들었다. 새 호출을 만드는 대신 실행 중인 세션끼리 내용을 주고받게 한 것이다.
스킬은 잘 작동했지만 tmux 위에 직접 만든 기능이라 계속 손봐야 했고, 어느 시점부터는 그 일도 피로해졌다. 그때 herdr을 발견했다.3 코딩 에이전트를 위한 터미널 멀티플렉서로, 에이전트가 작업 중인지 입력을 기다리는지를 인식하고 공식 명령과 에이전트용 스킬로 조작할 수 있었다. 내가 별도로 구현해 관리하던 기능을 도구가 지원하고 있었다.
다만 tmux 스킬에는 세션들이 서로의 존재를 알고 직접 소통한다는 장점이 있었는데, herdr로 옮기면서 그 부분을 잃어버렸다. 도구가 세션을 조작할 수 있어도 에이전트끼리 언제 누구에게 무엇을 전달할지는 별도의 규칙이 필요했다. 그 소통 방식을 herdr의 개선 스킬로 다시 구현했다.4 다른 세션에 물어볼 일이 생겨도 내가 중간에서 전달할 필요가 없어졌다.
다른 도구도 써 봤다. Orca가 화제가 되었을 때 하루 정도 사용했는데, 화면은 계속 갱신되면서도 내부 터미널 전체를 조작할 수 없게 되는 일을 겪었다. 기본 스킬도 기대한 만큼 동작하지 않았고, 모바일 사용 경험에도 완성도가 아쉽다고 느낀 부분이 있었다. 스킬에 내가 원하는 소통 방식을 더해야 한다는 점은 herdr-enhanced를 만든 이유와도 같았다. 하루 동안 사용했을 때의 경험이지, 지금의 Orca를 평가하려는 것은 아니다.
나는 잘 만들어진 도구가 있으면 그것을 쓰는 편이 좋다고 생각한다. herdr로 옮긴 이유도 그랬다. 다만 도구가 아직 내 작업을 안정적으로 지원하지 못한다면, 직접 만든 작은 도구를 고쳐 가며 쓰는 편이 나을 때도 있다. 공개된 도구의 수정이 반영되기를 기다리는 것보다 내가 수정할 수 있는 부분을 바로 고치는 쪽이 빠르기 때문이다. 기능의 수뿐 아니라 문제가 생겼을 때 얼마나 쉽게 고칠 수 있는지도 선택의 기준이 됐다.
herdr와 개선 스킬로 마련한 소통 방식은 Claude Code 밖에서도 활용할 수 있었다. 회사에서 제공하는 도구를 제외하면 Claude Max 20x 하나로 운용하다가, 9월에 Claude Code용 Claude Max 5x와 Codex용 ChatGPT Pro로 나눴다. 내가 선택한 구독은 각각 월 100달러였다. 이미 herdr와 개선 스킬을 쓰고 있었으므로 두 도구를 함께 운용하는 데 큰 어려움은 없었다. 서로 다른 에이전트 사이에서도 기존의 소통 방식을 쓸 수 있었다.
전달을 넘긴 뒤에도 생각할 문제가 있었다. 작업 중인 세션끼리 내용을 나누는 것에 더해, 다음 작업에서도 그 내용을 기억할 방법이 필요했다.
기억의 범위도 직접 정하고 싶었다
여러 프로젝트를 오가다 보면 한 프로젝트에서 얻은 노하우를 다른 곳에서도 쓰고 싶어진다. 여러 프로젝트에 걸친 판단도 생긴다. 어느 한 프로젝트에만 속하지 않는 지식인데, 프로젝트별 대화에 남겨 두면 다른 세션에서는 알기 어렵다. 이런 내용을 함께 보관할 곳이 필요했다.
세션을 정리하거나 컨텍스트를 압축할 때도 필요한 맥락이 빠질 수 있었다. 어제 왜 그렇게 결정했는지, 무엇을 이미 시도했고 왜 그만두었는지 내가 다시 설명해야 했다. 이번에는 이전 대화를 기억하는 일이 내 몫이었다.
Claude Code 자체의 메모리 기능도 있었지만, 나는 출시 당시부터 끄고 썼다. ChatGPT의 메모리는 잘 쓰고 있다. 다만 쓰다 보면 여러 맥락이 한꺼번에 기억되어, 지금 내가 원하는 주제에만 집중하기 어렵다고 느낄 때가 있었다. 이는 ChatGPT를 쓰면서 받은 인상이다. Claude Code의 메모리도 똑같이 동작한다고 확인한 것은 아니고, 지금은 어떤지도 모른다.
이 경험 때문에 작업에 쓰는 기억은 내가 직접 통제하고 싶었다. 어떤 종류의 정보를 남길지, 그 기억을 얼마나 강하게 반영할지, 프로젝트 사이에서 무엇을 공유하고 무엇을 분리할지를 직접 정할 필요가 있다고 생각했다. 기억을 많이 남기는 것만큼, 지금 작업에 어떤 기억을 사용할지도 중요했다.
내가 택한 방법은 프로젝트 바깥에 별도의 워크스페이스를 두고, 알아낸 것과 결정한 것을 파일로 남기는 것이었다. 파일로 남기면 무엇을 기억하고 있는지 직접 확인하고 수정할 수 있다. 여기에 어떤 기록을 어느 작업에서 읽게 할지 정하는 규칙을 더해, 기억의 범위를 관리하려 했다. 다음 세션은 그렇게 정한 기록을 읽고 시작하면 된다. 대화가 계속 유지되는 데 의존하지 않아도 이전 결정과 그 이유를 이어갈 수 있게 한 것이다.
기억을 함께 보관하더라도 실제 작업은 각 프로젝트의 규칙을 따라야 했다. 그래서 코드와 문서를 수정하는 일은 해당 프로젝트 디렉터리의 별도 세션에 맡겼다. 워크스페이스의 메인 세션은 여러 프로젝트에 걸친 일을 조율하는 역할로 두었다.
처음에는 메인이 프로젝트 세션의 결과를 받아 다른 세션에 다시 전달했다. 앞에서 내가 하던 중계를 이번에는 메인 세션이 맡은 것이다. 사람의 개입은 줄었지만 같은 정보를 다시 전달하는 데 토큰과 시간이 들었다. 직접 소통을 적용한 뒤에는 메인이 모든 내용을 전달할 필요가 없어졌고, 프로젝트에 걸친 판단과 기록을 조율하는 역할로 정리했다.
작업 중 필요한 내용은 세션끼리 나누고, 다음 세션에도 필요한 맥락은 파일로 남긴다. 이 구분 덕분에 내가 이전 대화를 기억해서 설명하는 일을 줄일 수 있었다.
기억을 공유해도 필요한 정보가 다 있는 것은 아니다
기록과 소통은 이미 알아낸 정보를 보존하고 전달하는 방법이었다. 작업 도중 새로 확인해야 할 정보가 생겼을 때, 에이전트가 직접 접근할 수 없으면 다시 나를 기다려야 했다.
데이터베이스 조회가 그런 경우였다. 코드와 문서만으로는 실제로 어떤 값이 저장되어 있는지까지 알 수 없다. 그 확인이 필요할 때면 내가 대신 조회해서 결과를 붙여 넣었다. 세션 바깥의 정보를 가져오는 일은 여전히 내 몫이었다.
이 일도 넘기려면 보여 줄 수 있는 정보를 구분해야 했다. 조회 결과를 그대로 전달하면 작업에 필요하지 않은 개인정보까지 컨텍스트에 들어갈 수 있기 때문이다. 필요한 데이터를 확인할 수 있도록 하면서, 보여 주지 않아야 할 값은 가릴 방법이 필요했다.
그래서 허용 목록에 없는 컬럼을 가려 주는 마스킹 래퍼를 만들었다. mysql과 psql의 인자를 그대로 받도록 해, 기존 명령에서 실행 파일 이름만 바꿔 쓸 수 있게 했다. 에이전트가 이미 알고 있는 조회 방식을 유지하면서 결과의 노출 범위를 제한하려는 의도였다.
목록의 방향은 의도적으로 정했다. 가릴 컬럼을 나열하면 이름이 바뀌거나 새 컬럼이 생겼을 때 값이 노출될 수 있다. 보여 줄 컬럼만 나열하면 그런 변화가 생겨도 기본적으로 가려진다. 필요한 정보를 제공하면서도 노출 범위를 제한하기 위한 선택이었다.
이렇게 접근 방법을 마련하자, 조회 결과를 내가 대신 전달하던 일도 에이전트에게 넘길 수 있었다.
검증과 이해도 나눠 맡길 수 있었다
필요한 정보를 직접 확인하게 해도, 검사할 때마다 나를 부르고 수정할 때마다 다음 지시를 기다린다면 나는 계속 작업 사이를 오가야 한다. 여기서 처음에 일을 맡기지 못한 이유로 돌아오게 됐다. 검증과 이해에 드는 과정도 전부 내가 해야 할까.
나는 먼저 에이전트에게 작업을 맡긴다. 그 작업을 어떻게 검증할지 방법을 찾고, 검증도 에이전트에게 위임한다. 검증에서 문제가 드러나면 고친 뒤 다시 확인하는 반복까지 맡긴다. 내가 검사 결과를 매번 읽어 다음 수정을 지시하는 방식으로는 여전히 모든 반복에 내 개입이 필요하다. 그래서 수정할 때마다 돌아오는 과정을 줄이고, 검증과 수정의 반복 자체를 위임하고 있다.
이해도 비슷하다. 동료가 조사한 내용을 공유받을 때 그 사람이 읽은 자료를 처음부터 전부 읽지는 않는다. 정리된 설명을 듣고 내가 이미 아는 것과 연결해 상황을 이해한다. 에이전트에게도 그런 수준의 설명을 받는다. 내 기반 지식으로 근거와 의미를 이해하고 결정할 수 있다면, 자료를 읽고 비교하고 요약하는 과정까지 직접 할 필요는 없다.
그러므로 요약이 짧다는 것만으로 충분하지는 않다. 검증을 통과했다는 말에 더해 무엇을 확인했고 어떤 근거로 결론을 냈는지가 필요하다. 코드와 자료를 읽고 비교한 다음, 판단에 필요한 맥락을 남겨 정리하는 일까지 위임하는 것이다. 검증기가 잘못된 대상을 검사하거나 요약에서 필요한 정보를 빠뜨릴 가능성은 남는다. 그런 한계를 이해할 수 있는 설명을 준비하고, 부족한 근거를 보완하는 작업도 위임할 수 있다.
내 방식에서 중요한 것은 판단에 충분한 이해를 갖추되, 그 이해를 얻는 과정은 도구와 나누는 것이다. 원자료를 전부 직접 읽어야만 이해할 수 있다고 보지는 않는다. 검증도 같은 이유로 사람이 반드시 직접 수행해야 할 일이라고 전제하지 않는다.
지금 내린 결론
이 일을 가능하게 하는 도구와 규칙을 이 글에서는 하네스라고 부른다. 지금 내가 환경을 판단하는 기준은 세 가지다.
- 컨텍스트는 안전하게 충분히 준다. 내가 대신 확인해 주는 일이 반복되면, 필요한 정보를 안전하게 제공할 방법을 찾는다.
- 내 개입을 반복해서 요구하는 과정을 나누어 맡긴다. 전달과 기억뿐 아니라 검증·수정의 반복, 판단에 필요한 설명을 준비하는 일도 포함한다.
- 사람의 집중력은 결정에 쓴다. 내 기반 지식으로 이해하고 판단할 수 있는 설명을 받는 것이 기준이다.
물론 환경을 유지하는 일은 남는다. 스킬을 손봐야 했고, 메인 세션에 전달이 집중되자 소통 방식도 고쳐야 했다. 새로운 자동화를 만들 때는 없앨 반복 작업과 앞으로 관리할 일을 함께 봐야 한다.
맺으며
처음에는 에이전트에게 맡길 수 있는 일이 얼마 없다고 생각했다. 지금은 당연히 내 몫이라고 여겼던 행동 중에 도구와 나눌 수 있는 것이 얼마나 있는지를 먼저 생각한다. 내게 필요한 변화는 작업에 돌아갈 때마다 맥락을 더 빨리 파악하는 것과, 애초에 돌아가야 하는 횟수를 줄이는 것이었다.
다음 병목도 아마 나일 것이다. 지금도 내가 반복해서 하는 일 중에 아직 넘겨보지 않은 것이 있을지 모른다. 환경을 고치는 일은 그런 행동을 하나씩 찾아내는 일에 더 가깝지 않을까.
각주
-
Anthropic, "Use the Claude Agent SDK with your Claude plan": "Update June 15: We're pausing the changes to Claude Agent SDK usage described below." ↩
-
seonggukchoi/skills 에 herdr-enhanced 로 공개해 두었다. ↩